模型与声音训练上传方法
- 先更新客户端,更新完成后重新启动。
- 启动客户端后,在主界面进入"Digital Twin"(数字分身)。
- 推荐使用 V6 声音训练。要求:正常说话、佩戴降噪麦克风,录制 3–15 秒音频即可快速克隆(若想获得最自然的效果,请使用 20 分钟以上的纯净音频 — 参见第 17 节)。
V6 与 V9 声音的区别:进行 V9 声音训练时,必须在训练前先提高音频音量;V9 声音占用的电脑性能更低。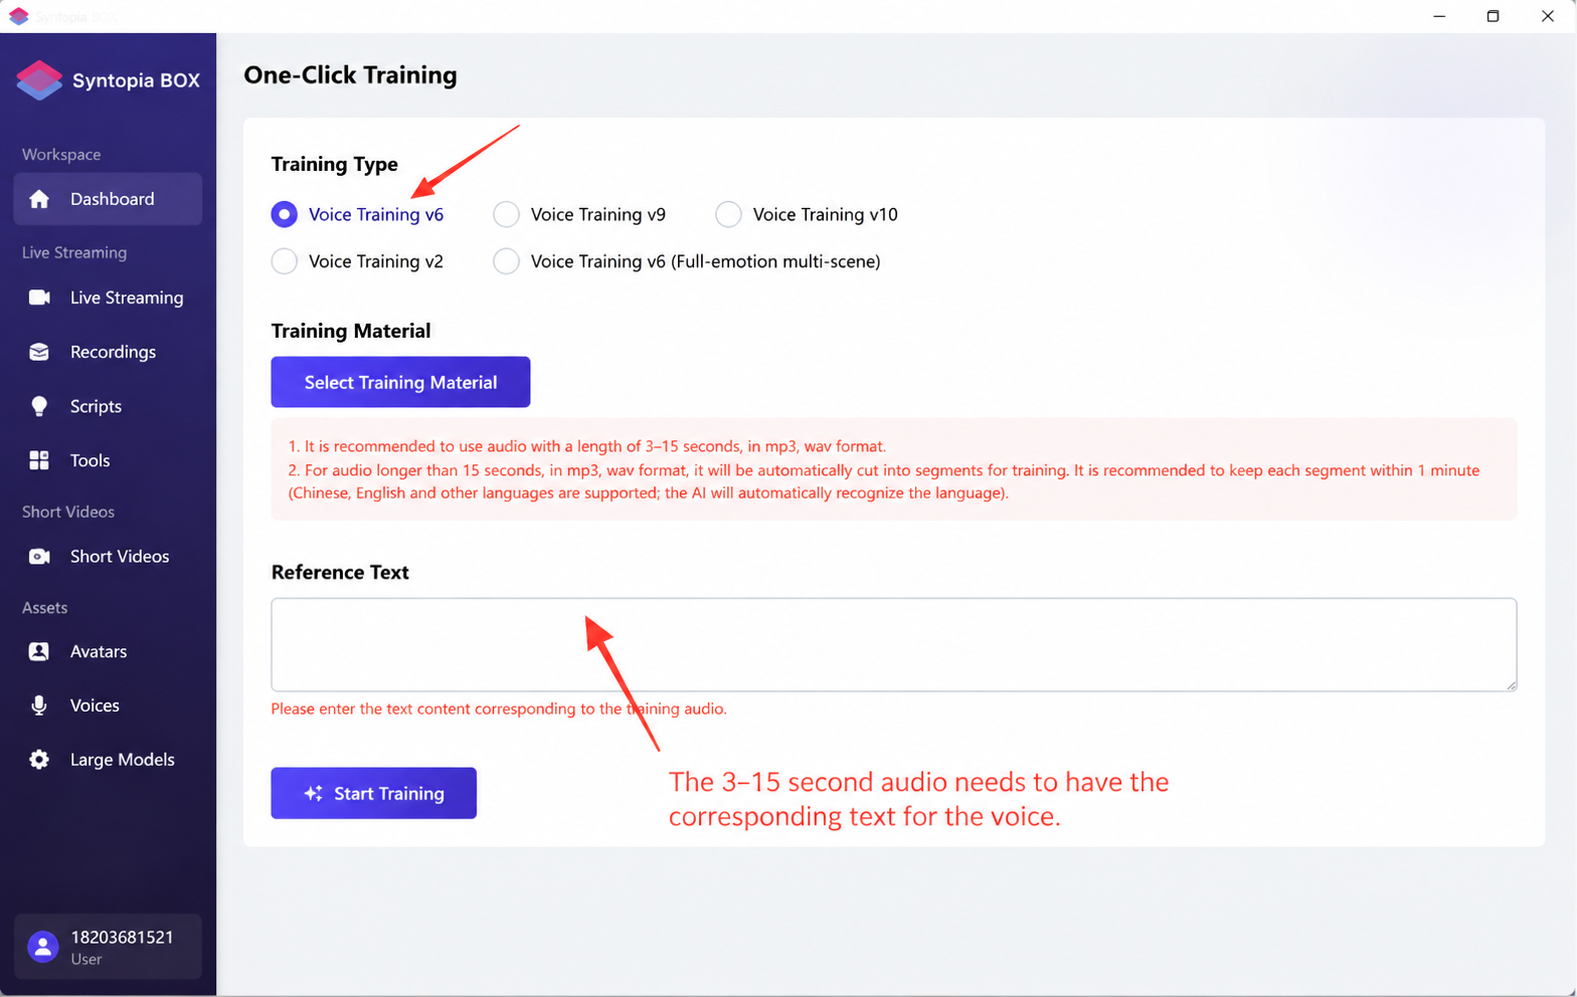
4. 数字人形象训练
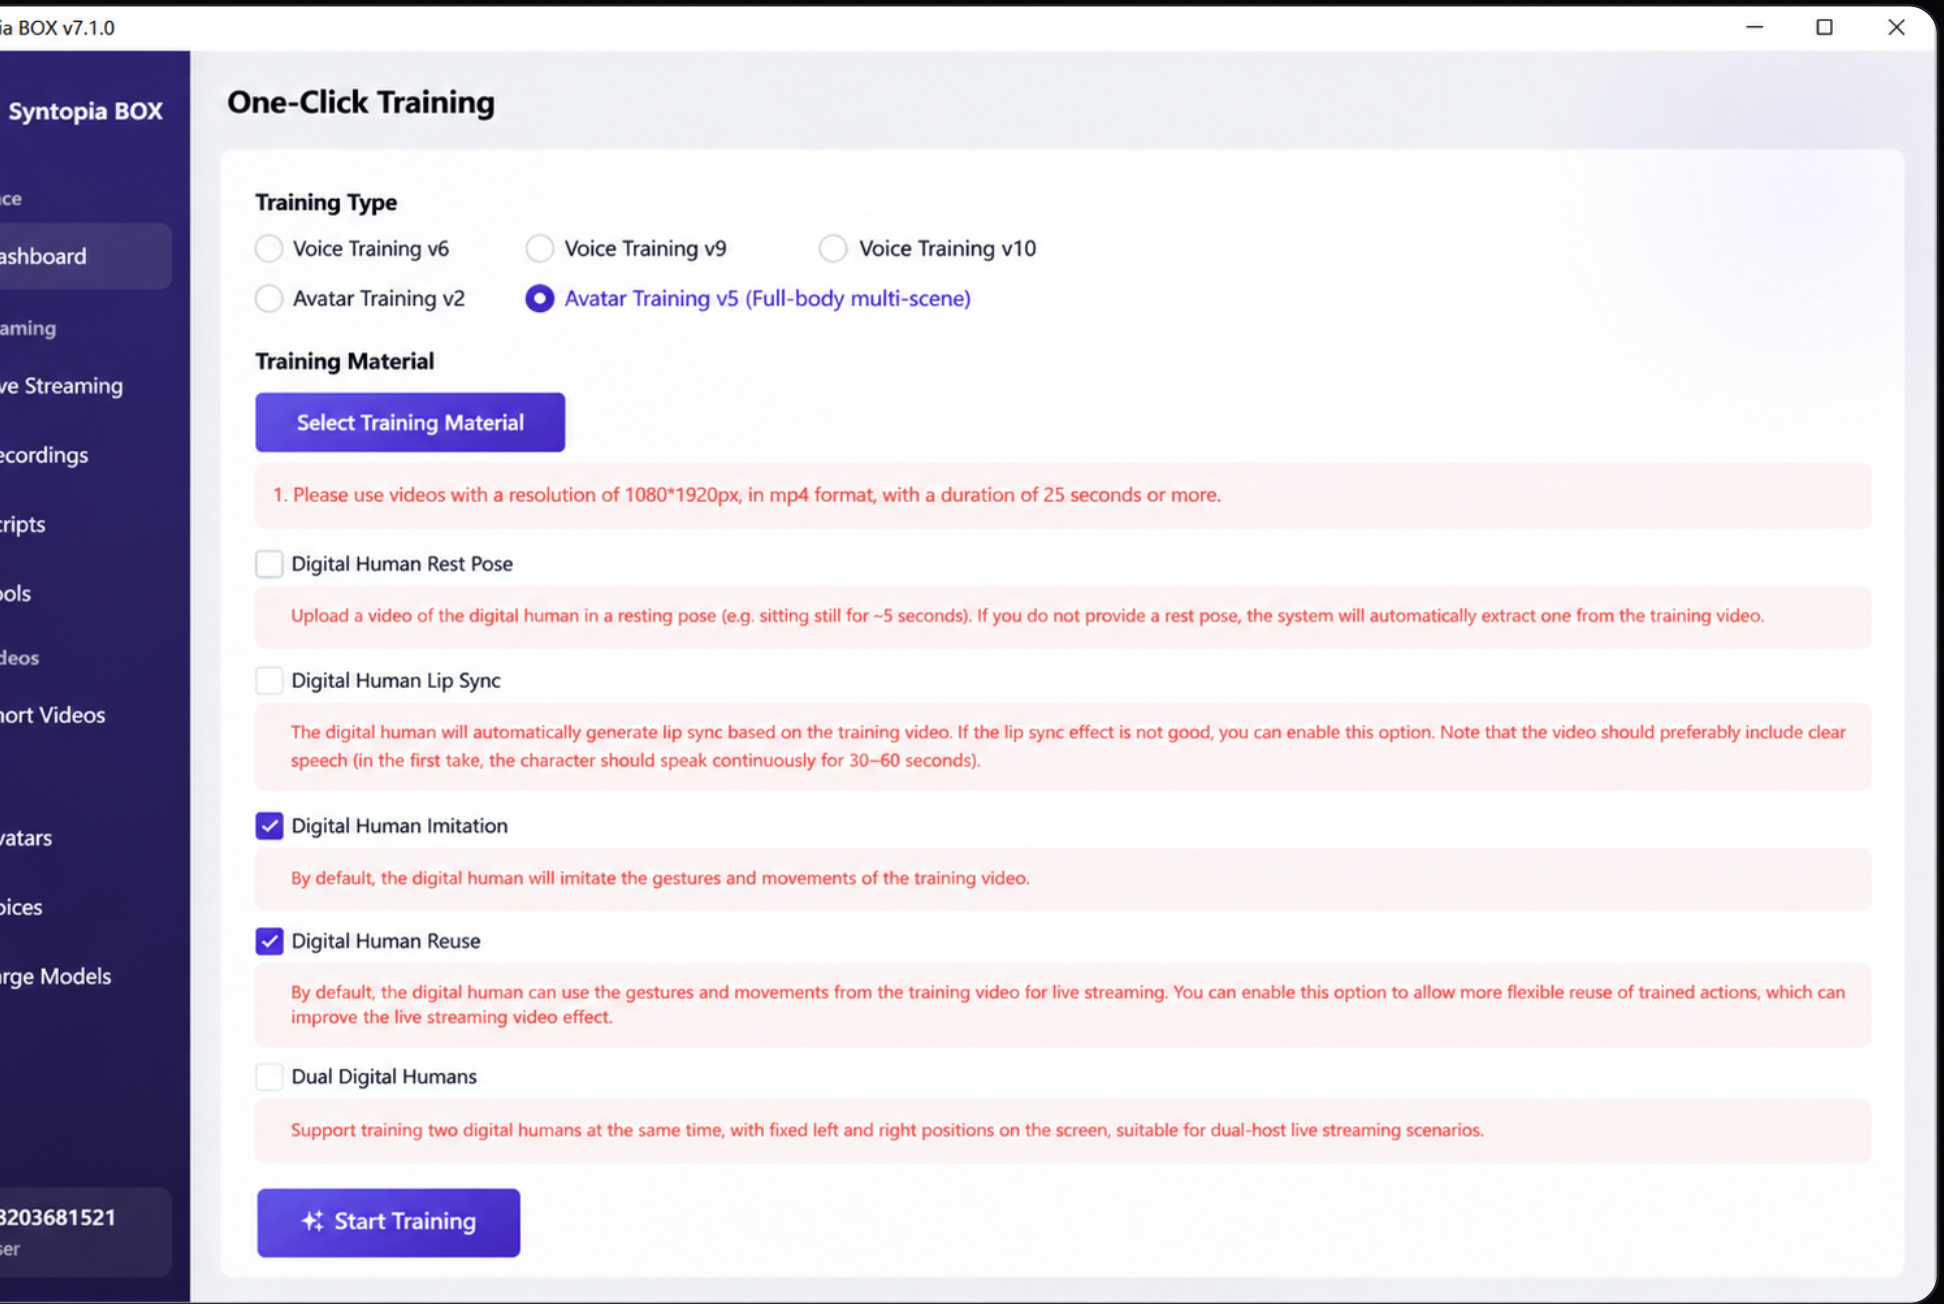
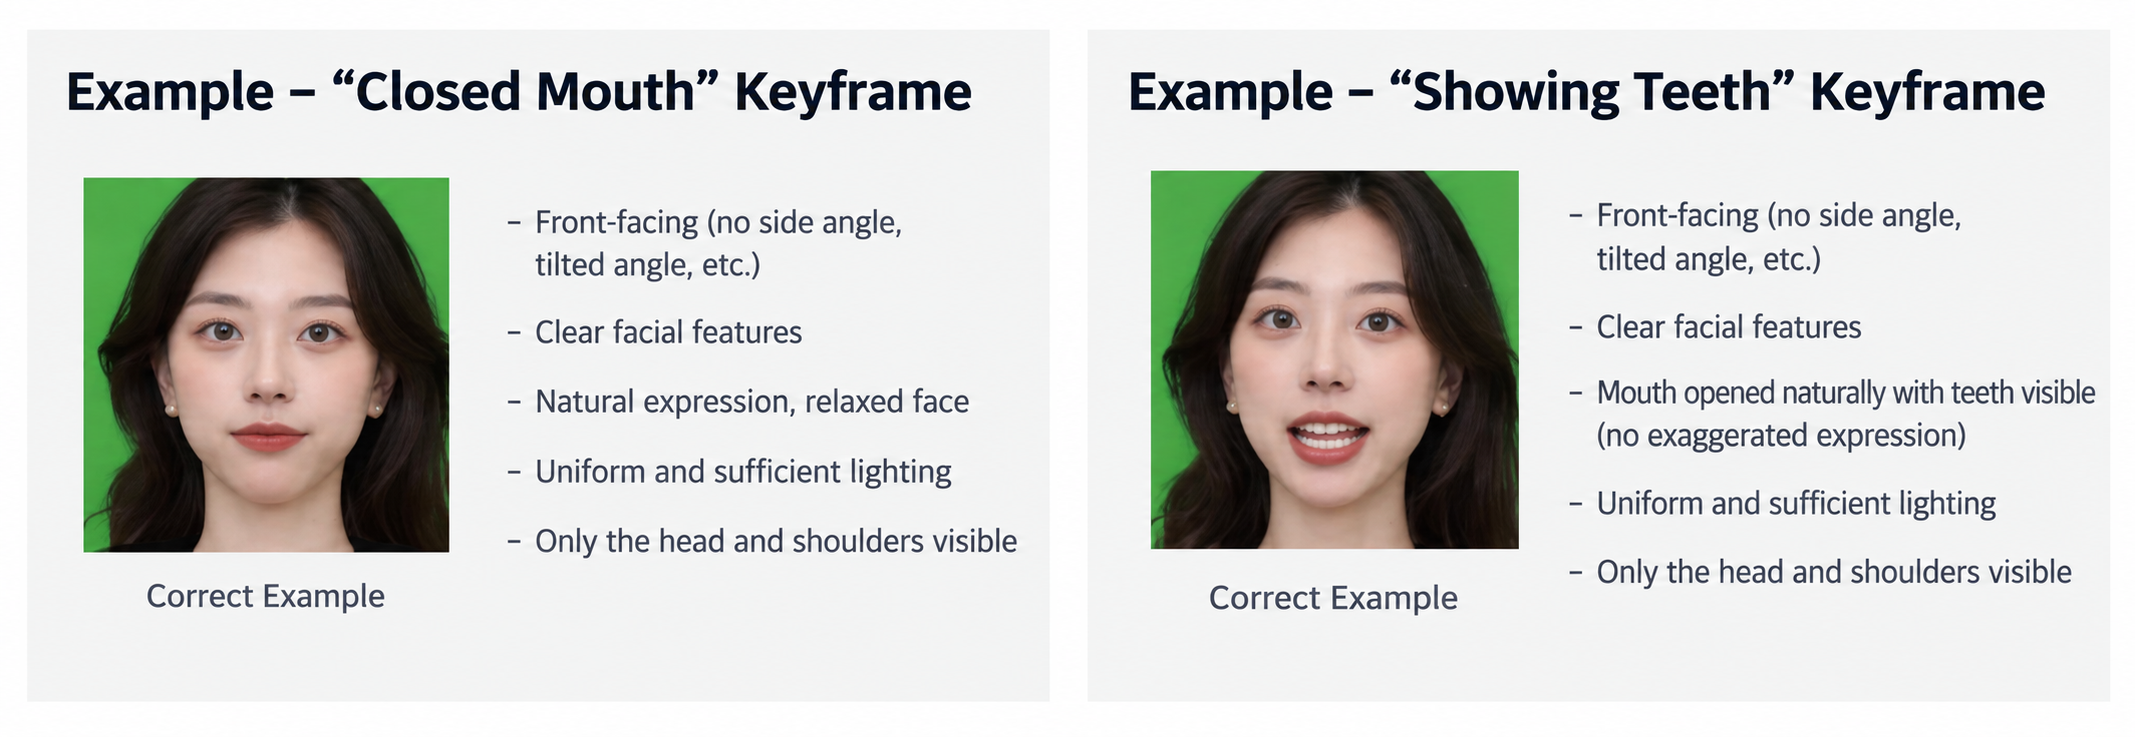
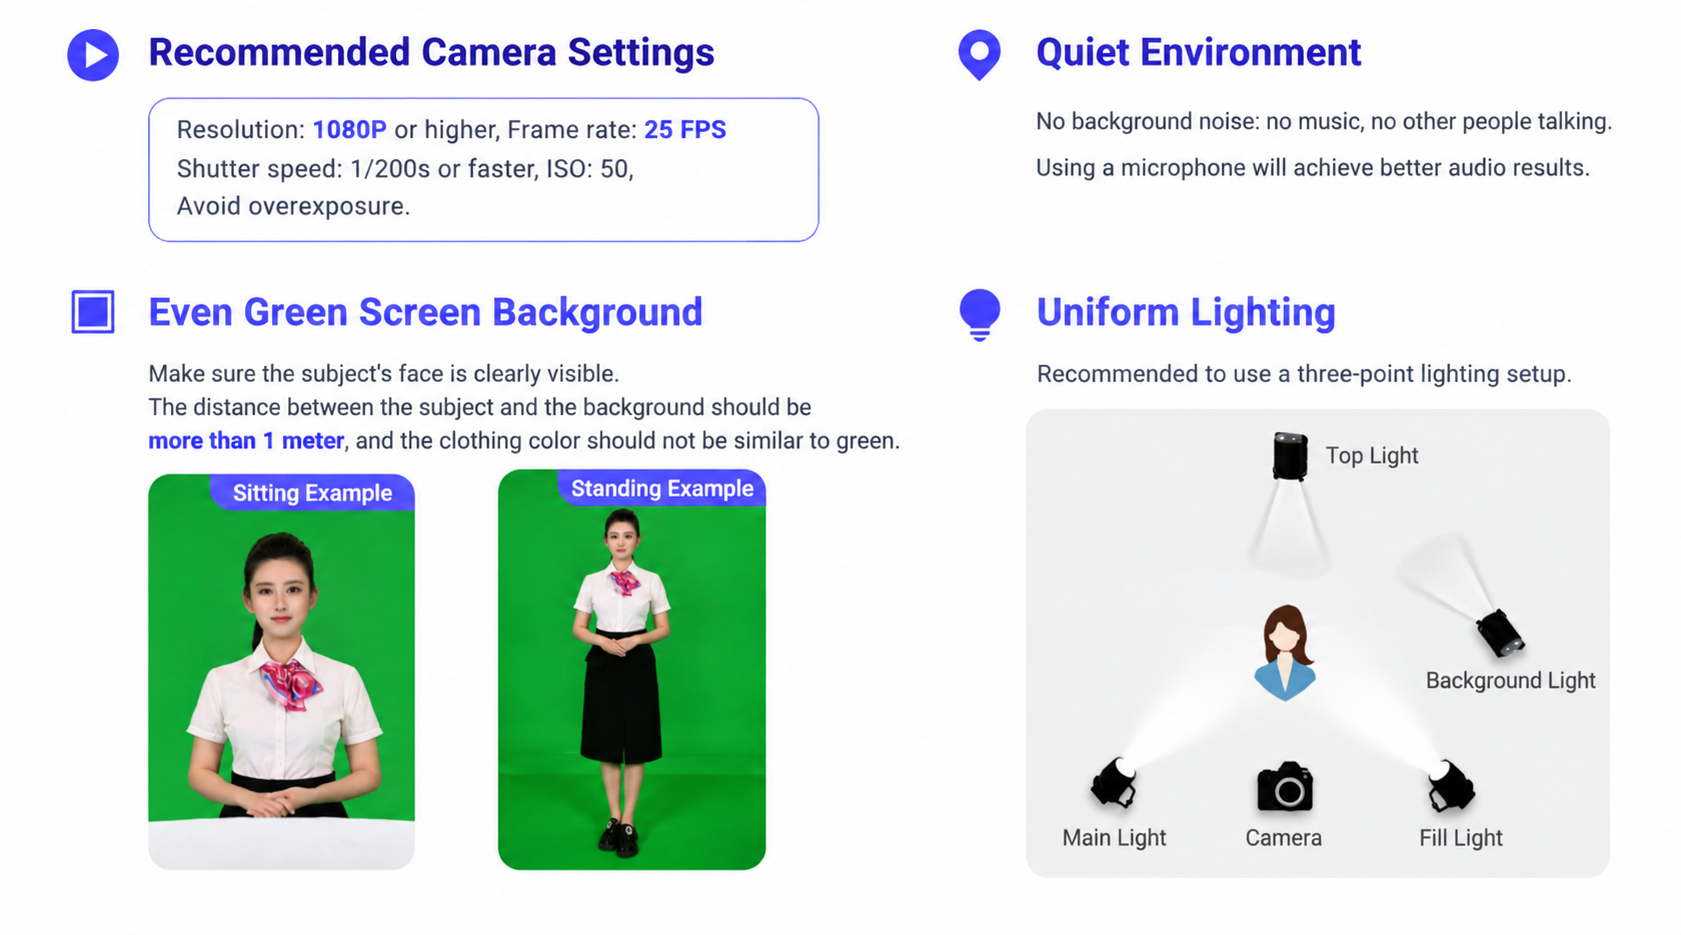
V2 数字人形象对源视频要求很高 — 你必须正常说话、佩戴降噪麦克风,并保持环境安静。V3/V5 数字人形象对源视频中的音频没有要求;训练 V5 数字人形象前必须先启用 GPU 加速。
查看 声音克隆采集标准与参考。
查看 V2/V3 模型绿幕视频处理方法。
查看 双人数字人主播形象录制标准。
推荐训练 V5 数字人形象;V5 数字人形象占用更多电脑性能,因此如果直播卡顿,请改为训练 V2/V3 数字人形象。
对于 V5 数字人形象,"Close Mouth"(闭嘴)和"Reverse Playback"(倒放)默认勾选;其他选项可以忽略、无需勾选。
5. 上传形象 / 声音
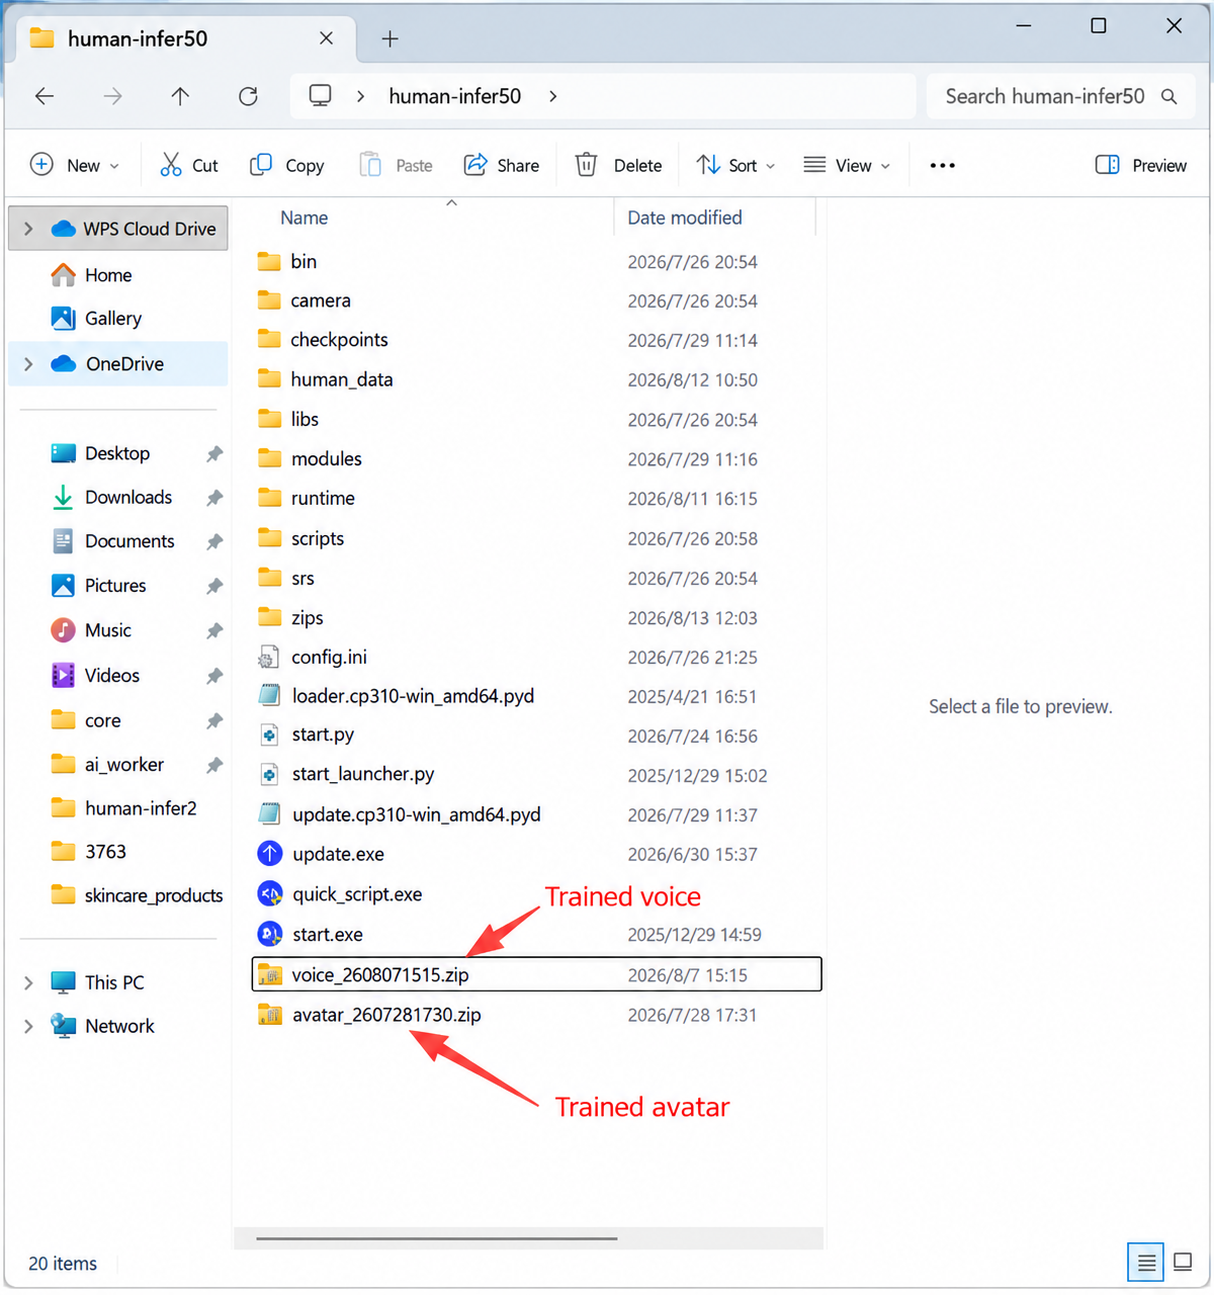
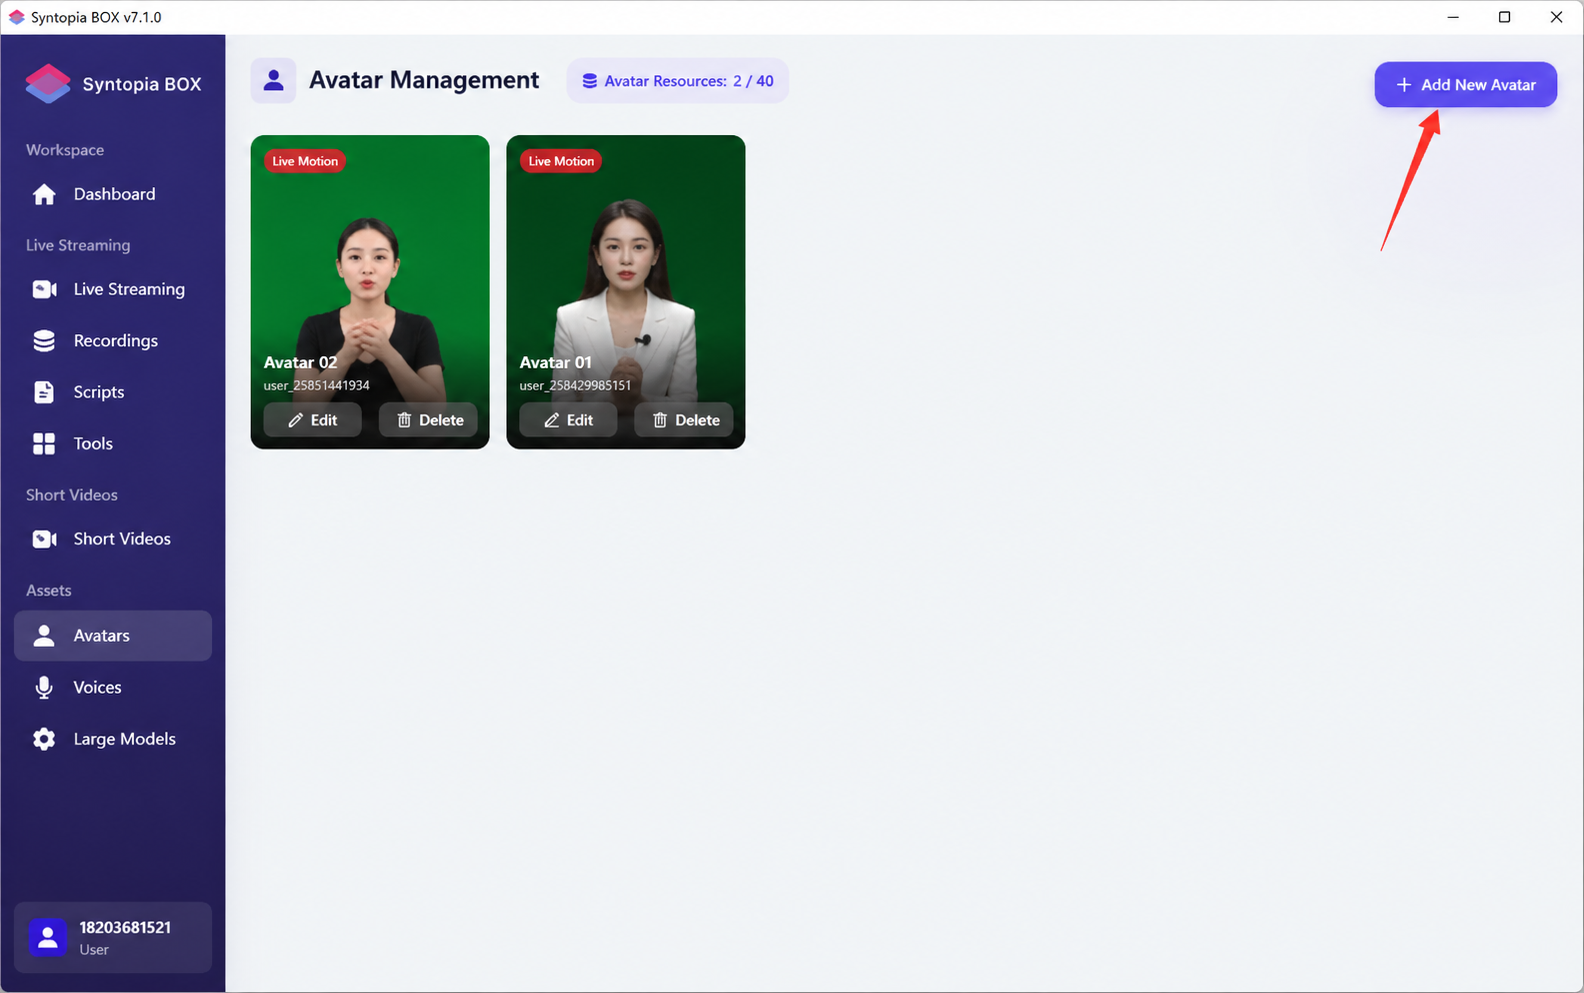
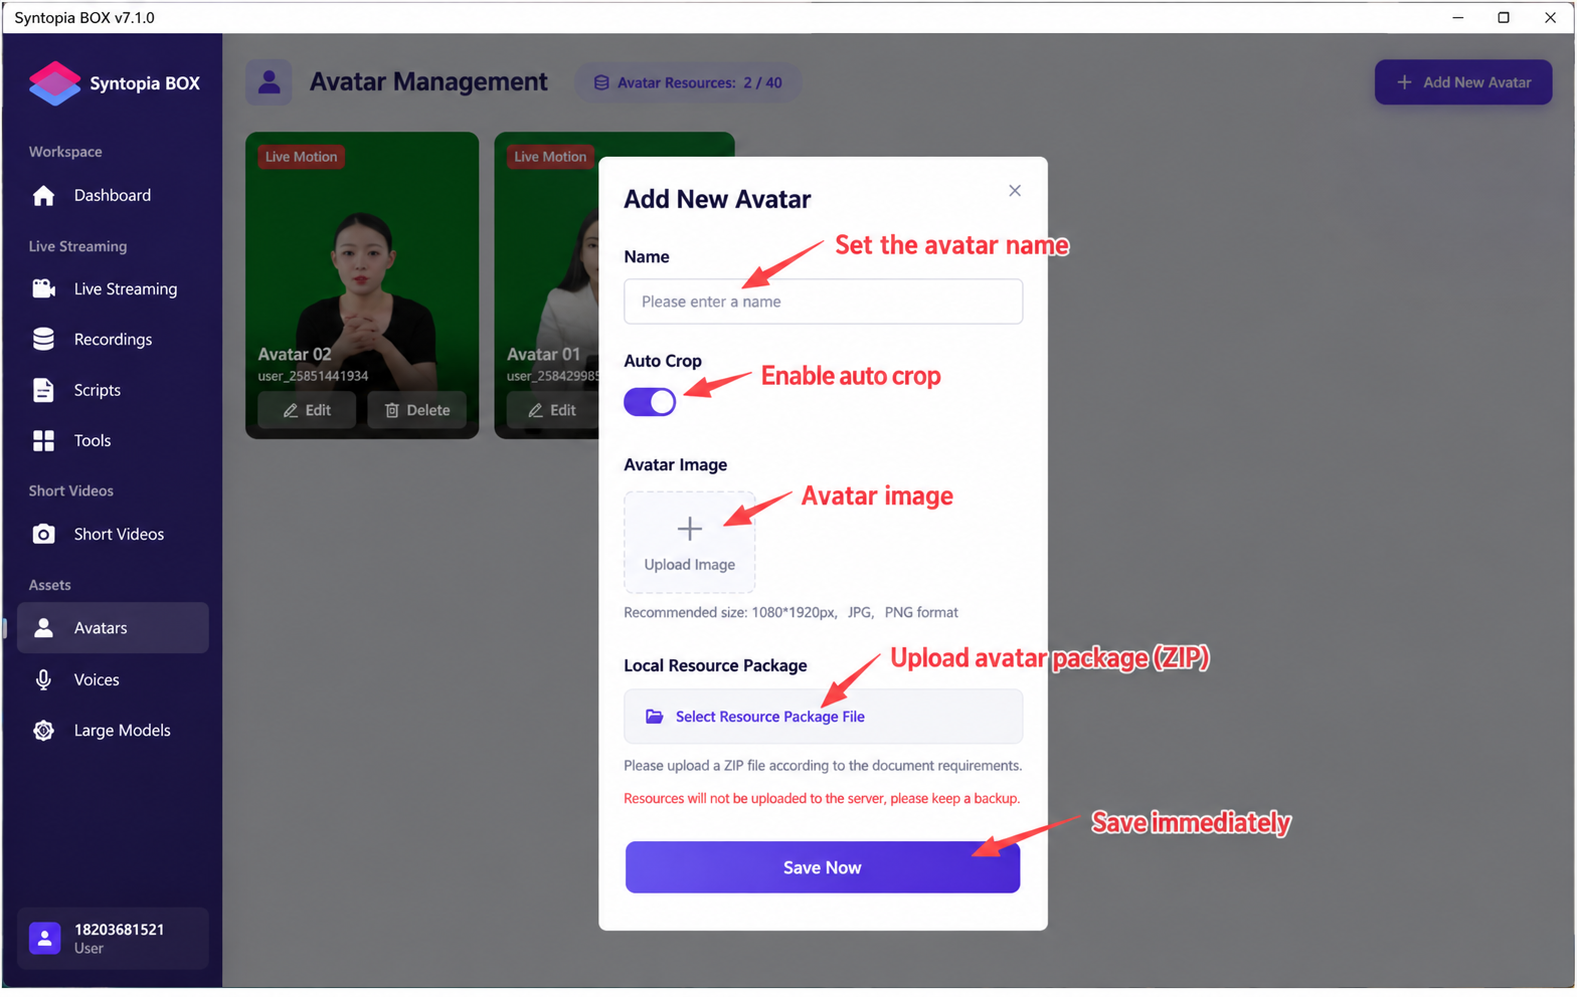
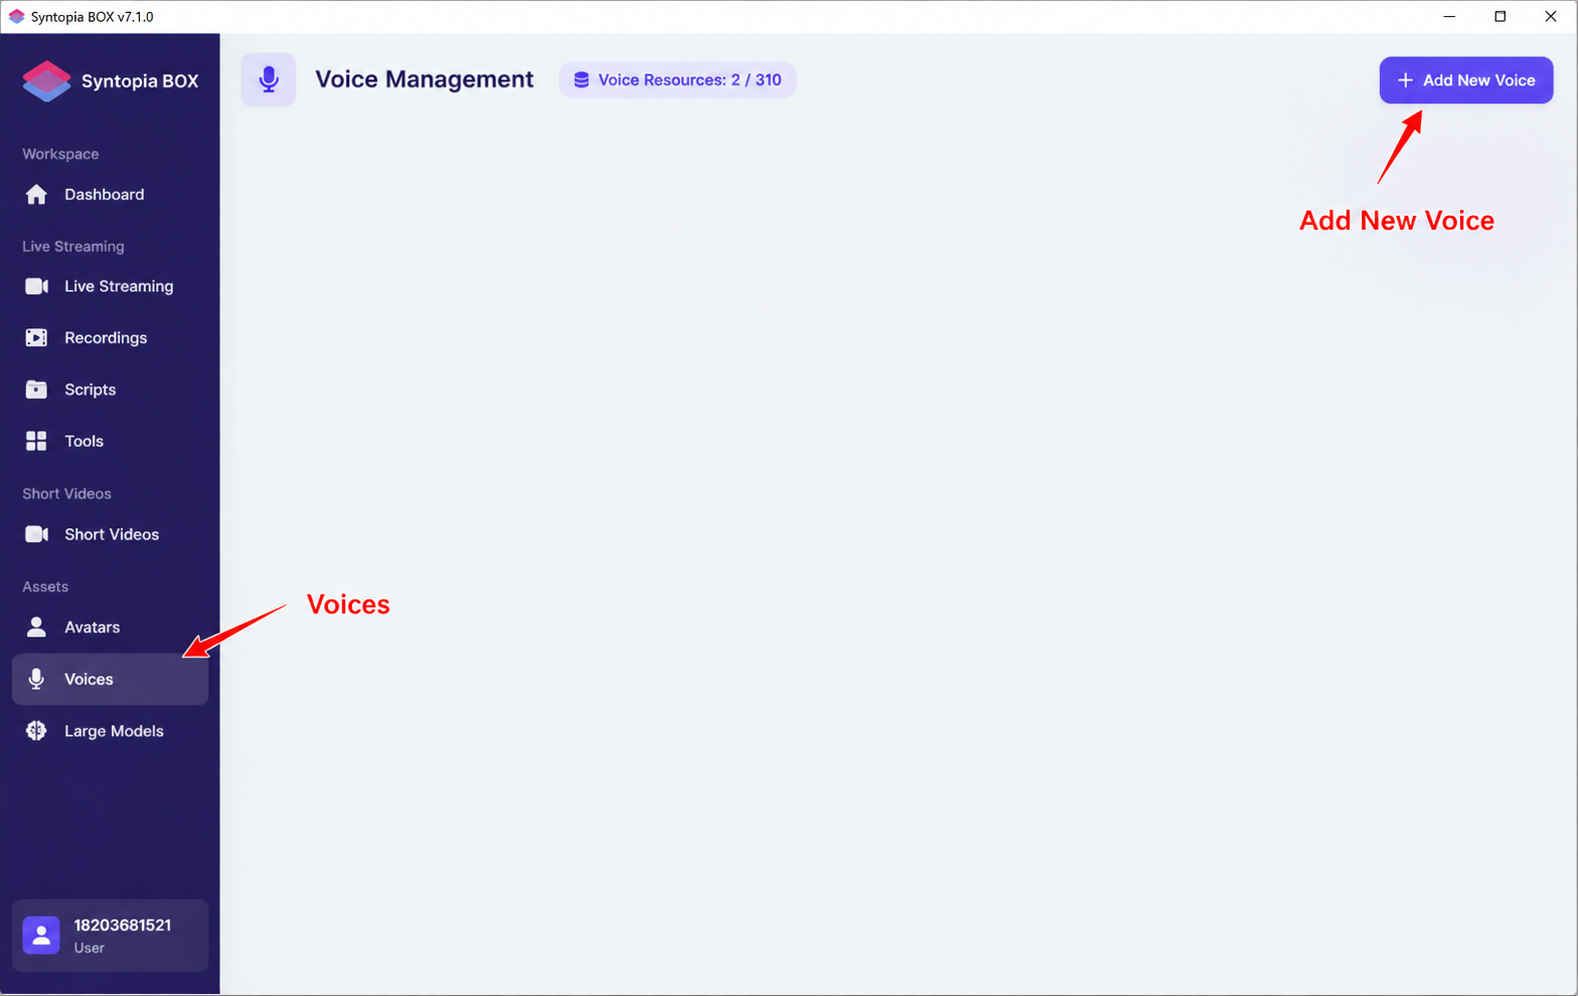
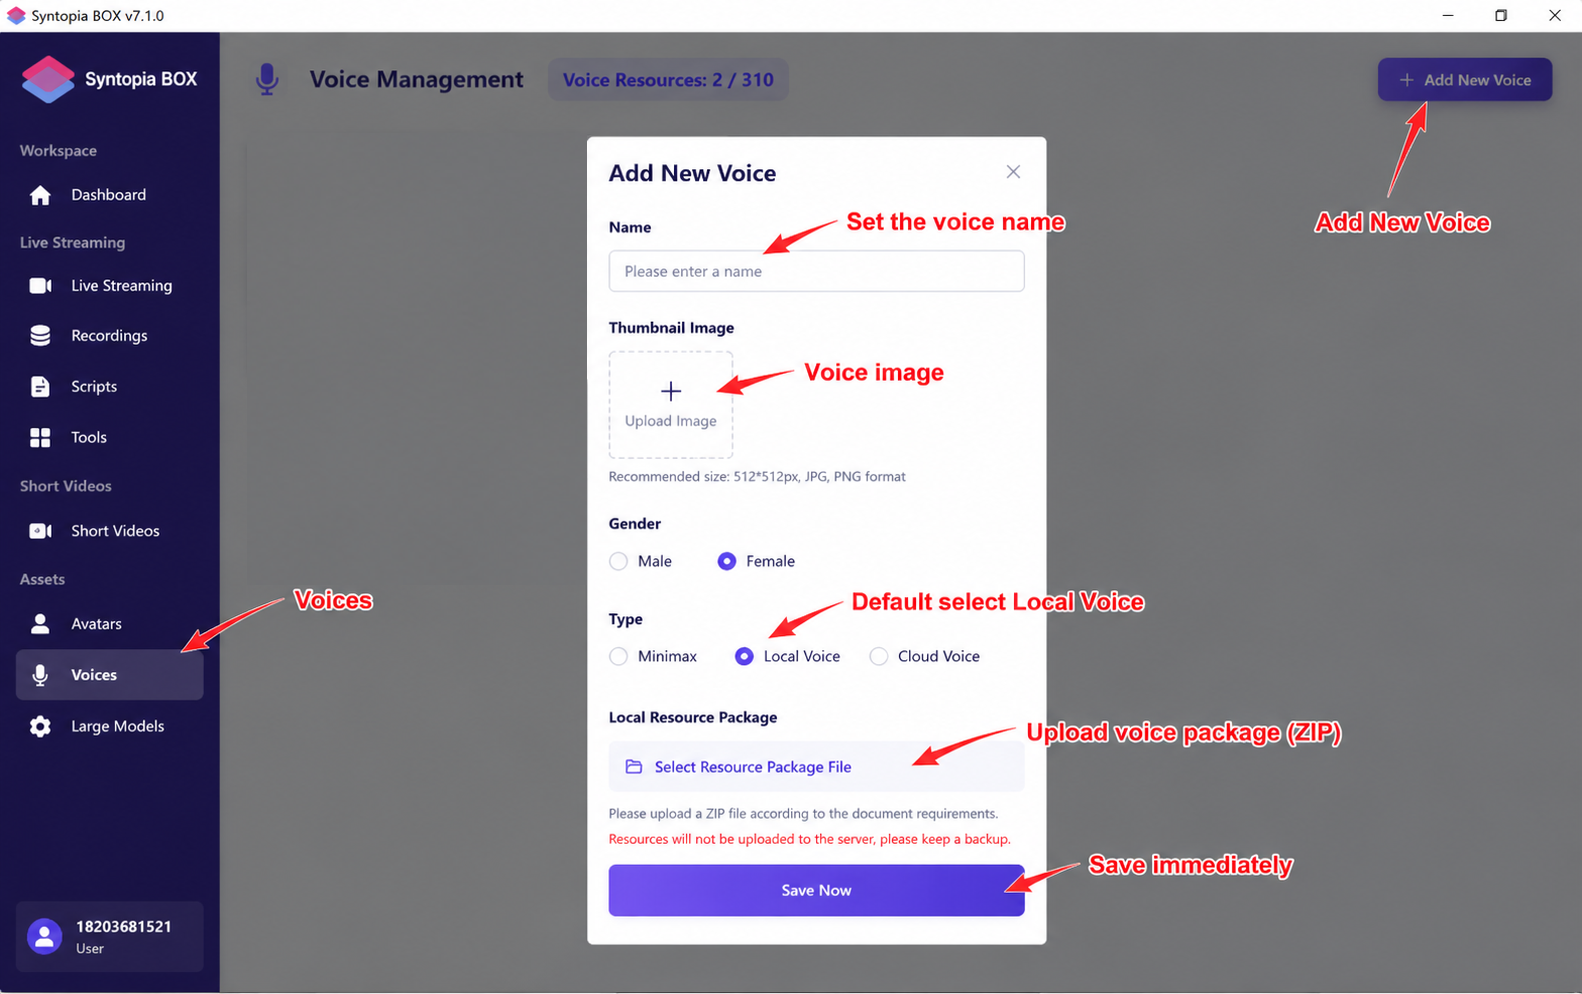
训练完形象或声音后,安装目录中会生成一个形象 / 声音的 zip 压缩包。在客户端主界面的"Model"(模型)/"Voice"(声音)处,上传对应训练好的模型或声音 zip 压缩包。