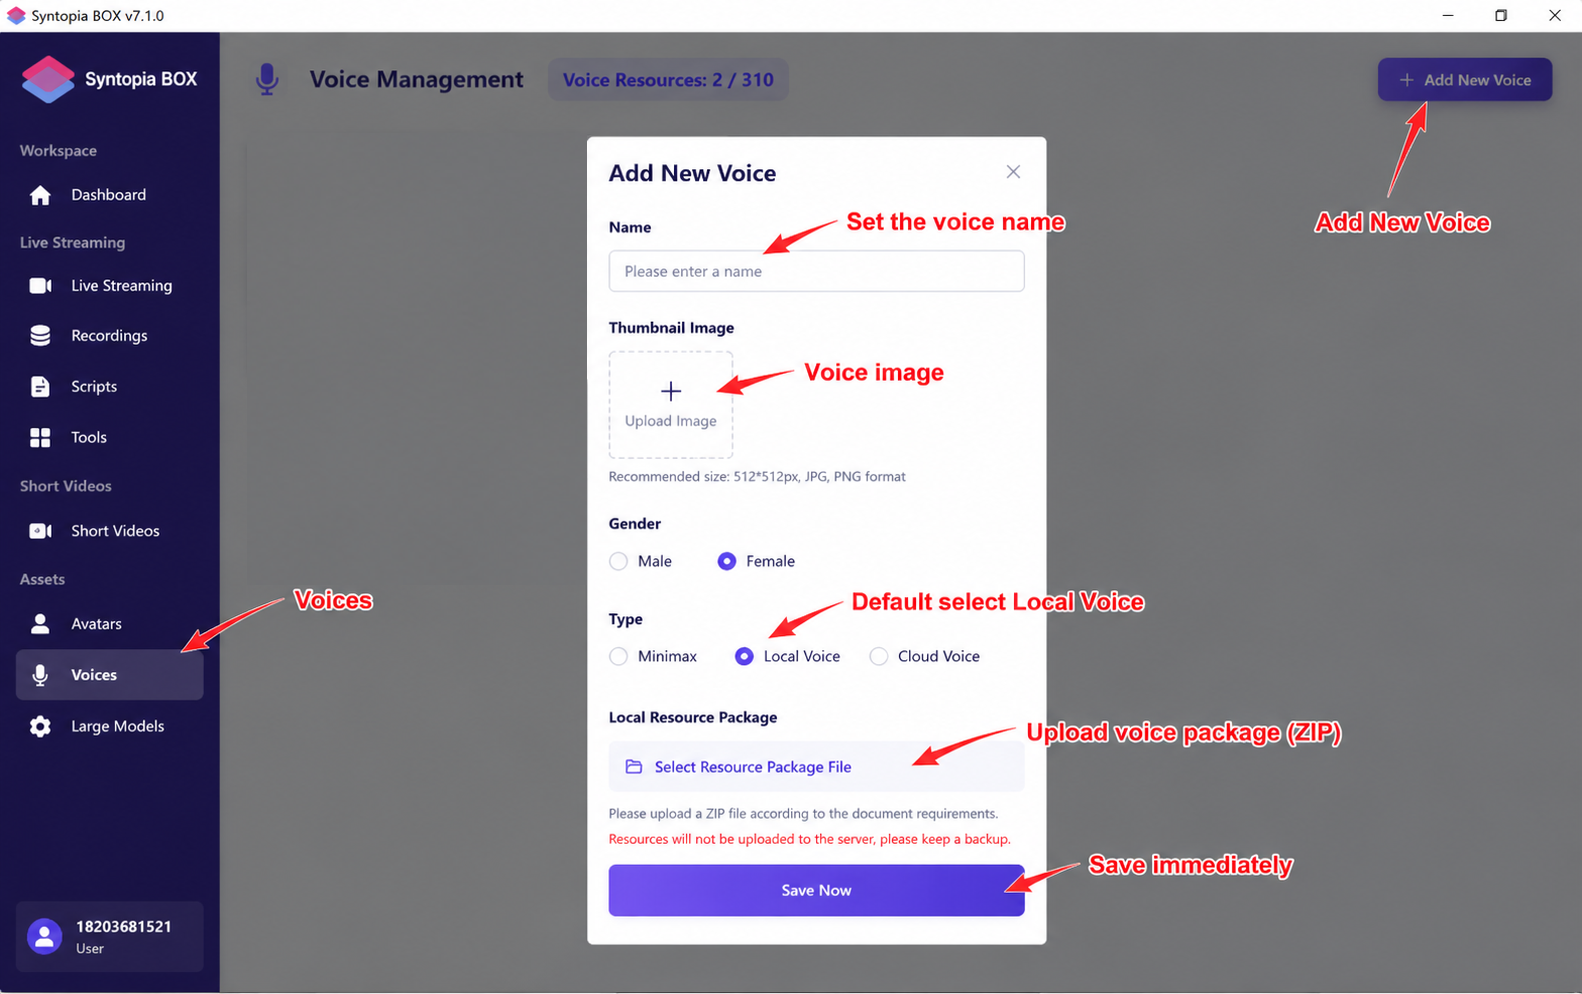
模型與語音訓練上傳方法
- 請先更新用戶端,更新完成後再重新啟動。
- 啟動用戶端後,進入主畫面的「Digital Twin」。
- 建議使用 V6 語音訓練。要求:正常說話、配戴降噪麥克風,並錄製 3–15 秒音訊即可快速複製(若想得到最自然的效果,請使用 20 分鐘以上的乾淨音訊 — 參見第 17 章)。
V6 與 V9 語音的差異:進行 V9 語音訓練時,訓練前必須先提高音訊音量;V9 語音佔用的電腦效能較少。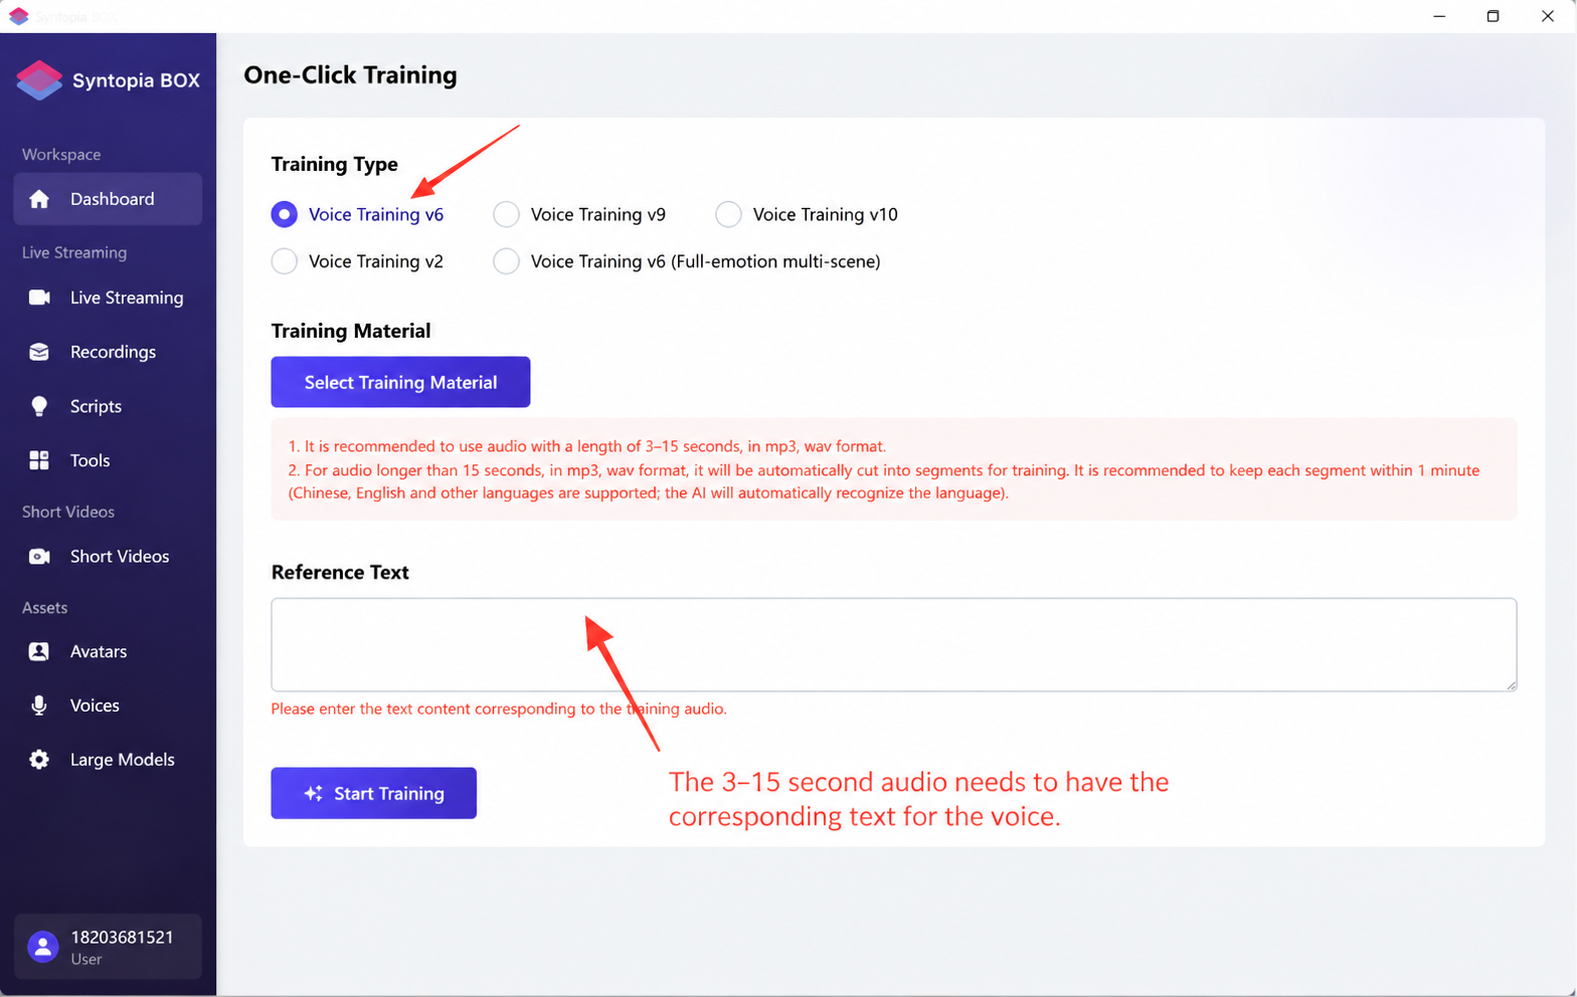
4. 形象訓練
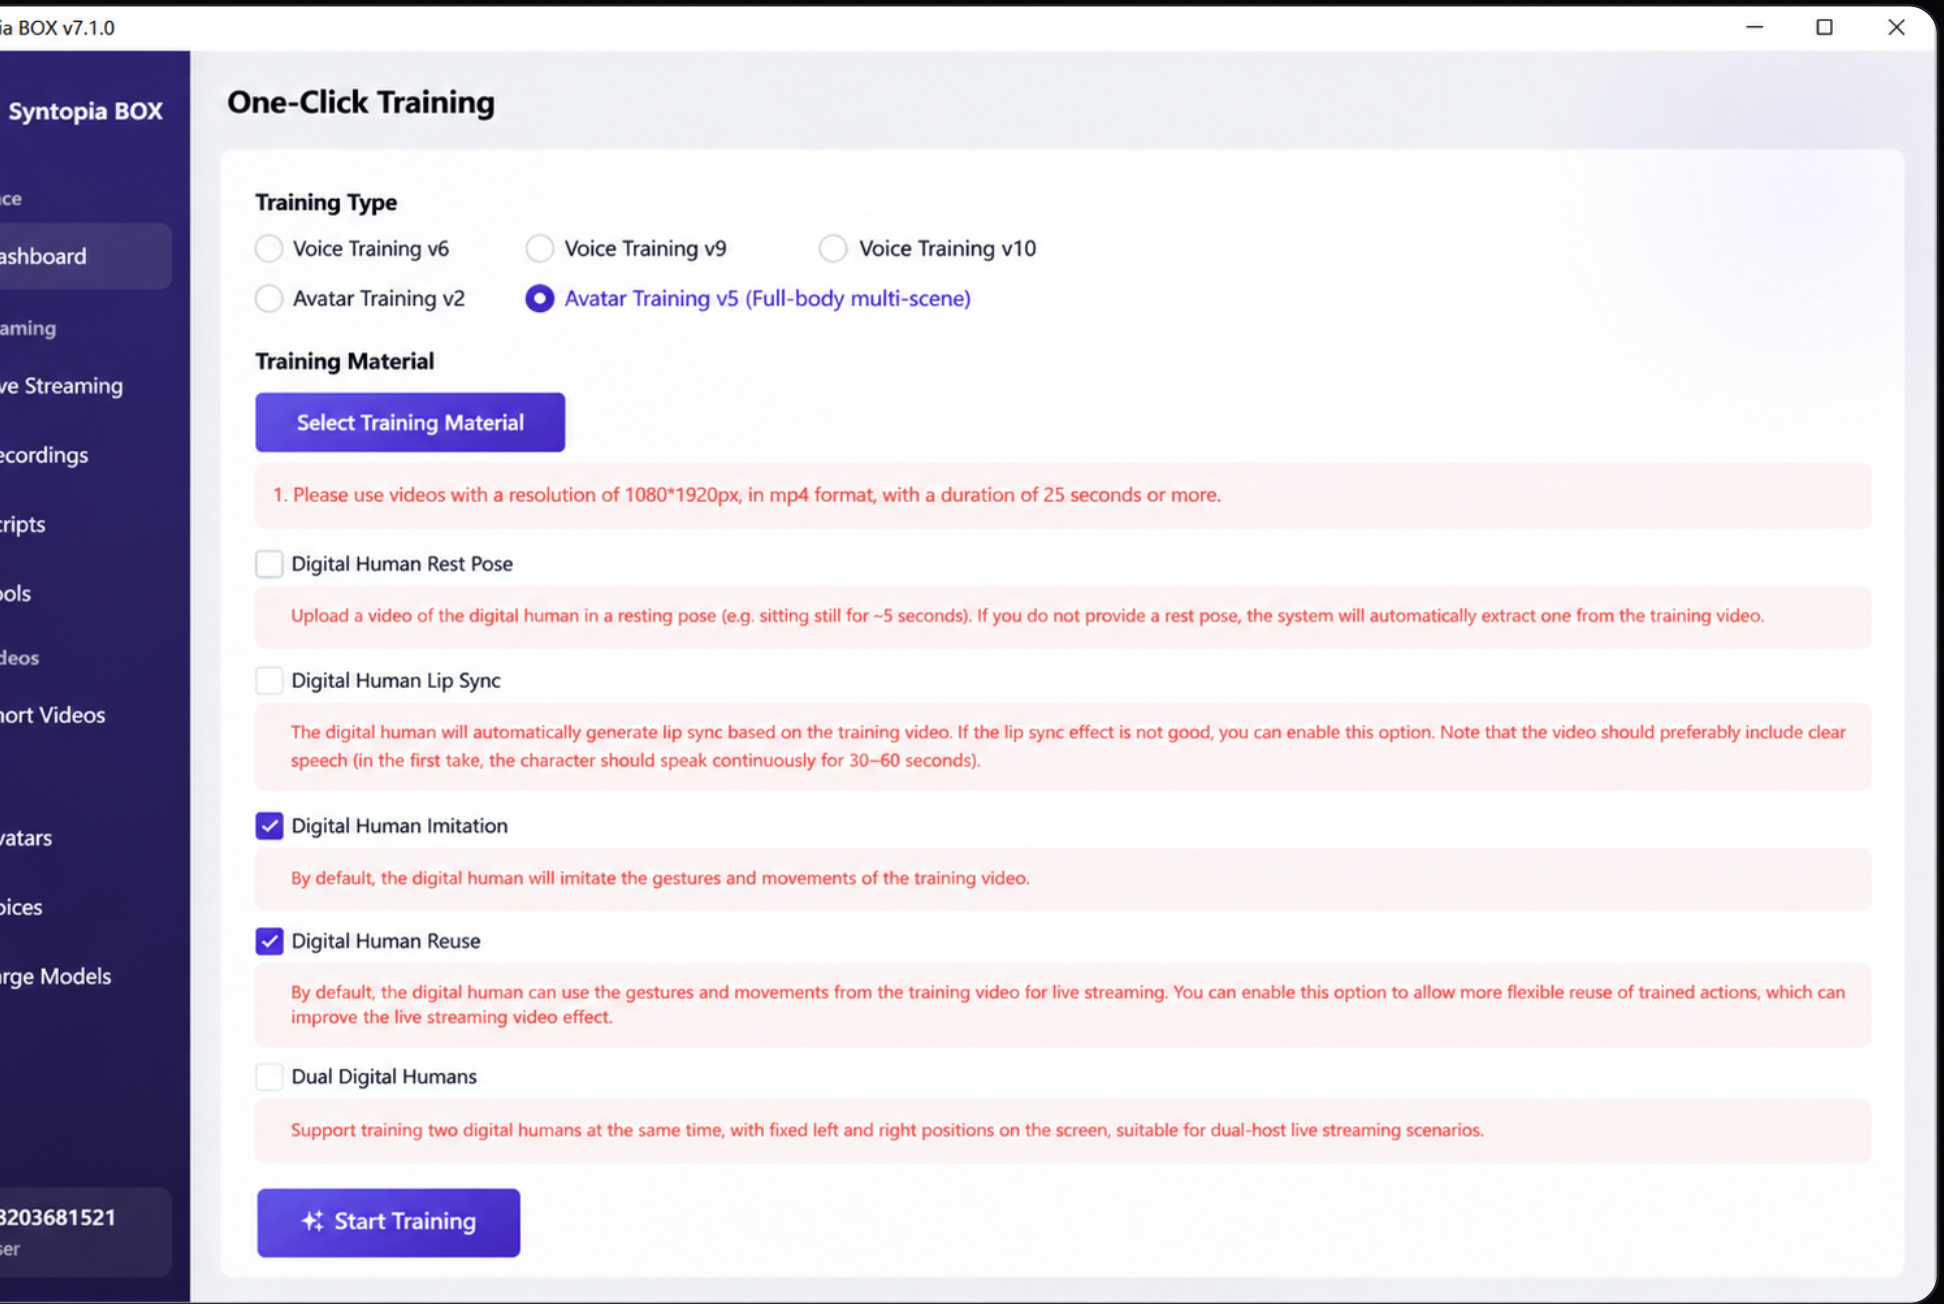
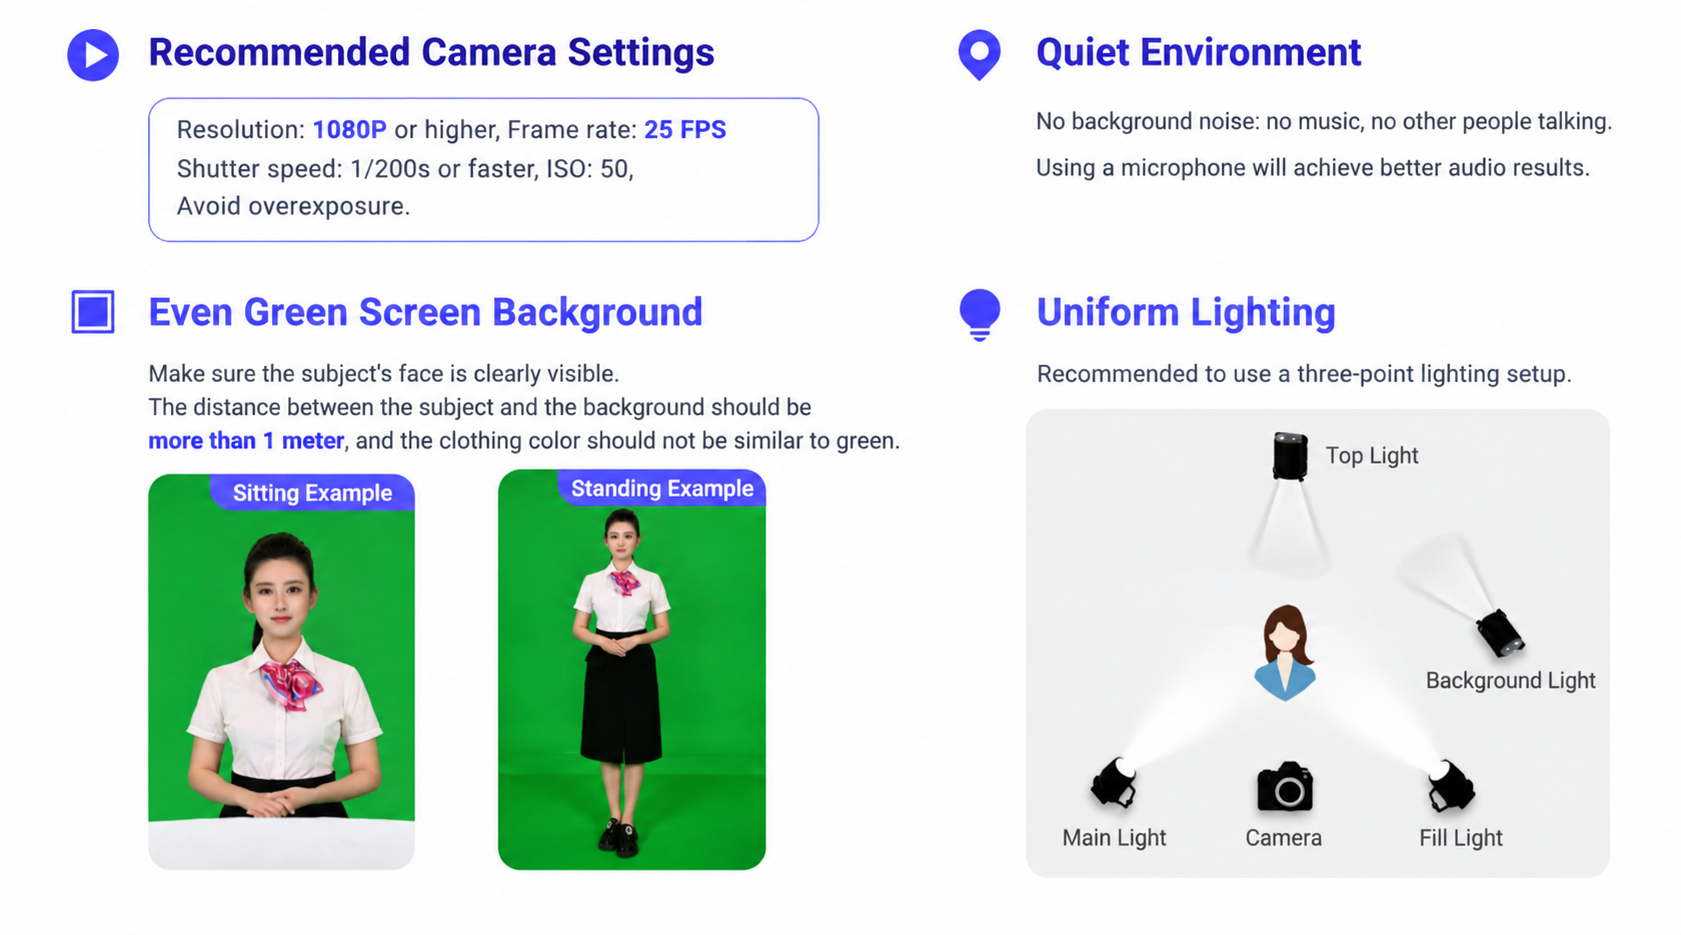
V2 形象對來源素材要求很高 — 你必須正常說話、配戴降噪麥克風,並保持環境安靜。V3/V5 形象對來源素材中的音訊沒有要求;訓練 V5 形象前必須啟用 GPU 加速。
查看 聲音複製採集標準與參考。
查看 V2/V3 模型綠幕影片處理方法。
查看 雙人數位人主播形象錄製標準。
建議進行 V5 形象訓練;V5 形象佔用的電腦效能較多,因此若直播出現卡頓,請改為訓練 V2/V3 形象。
使用 V5 形象時,「Close Mouth」(閉嘴)與「Reverse Playback」(倒放)預設為勾選;其他選項可忽略、不勾選。
5. 上傳形象/聲音
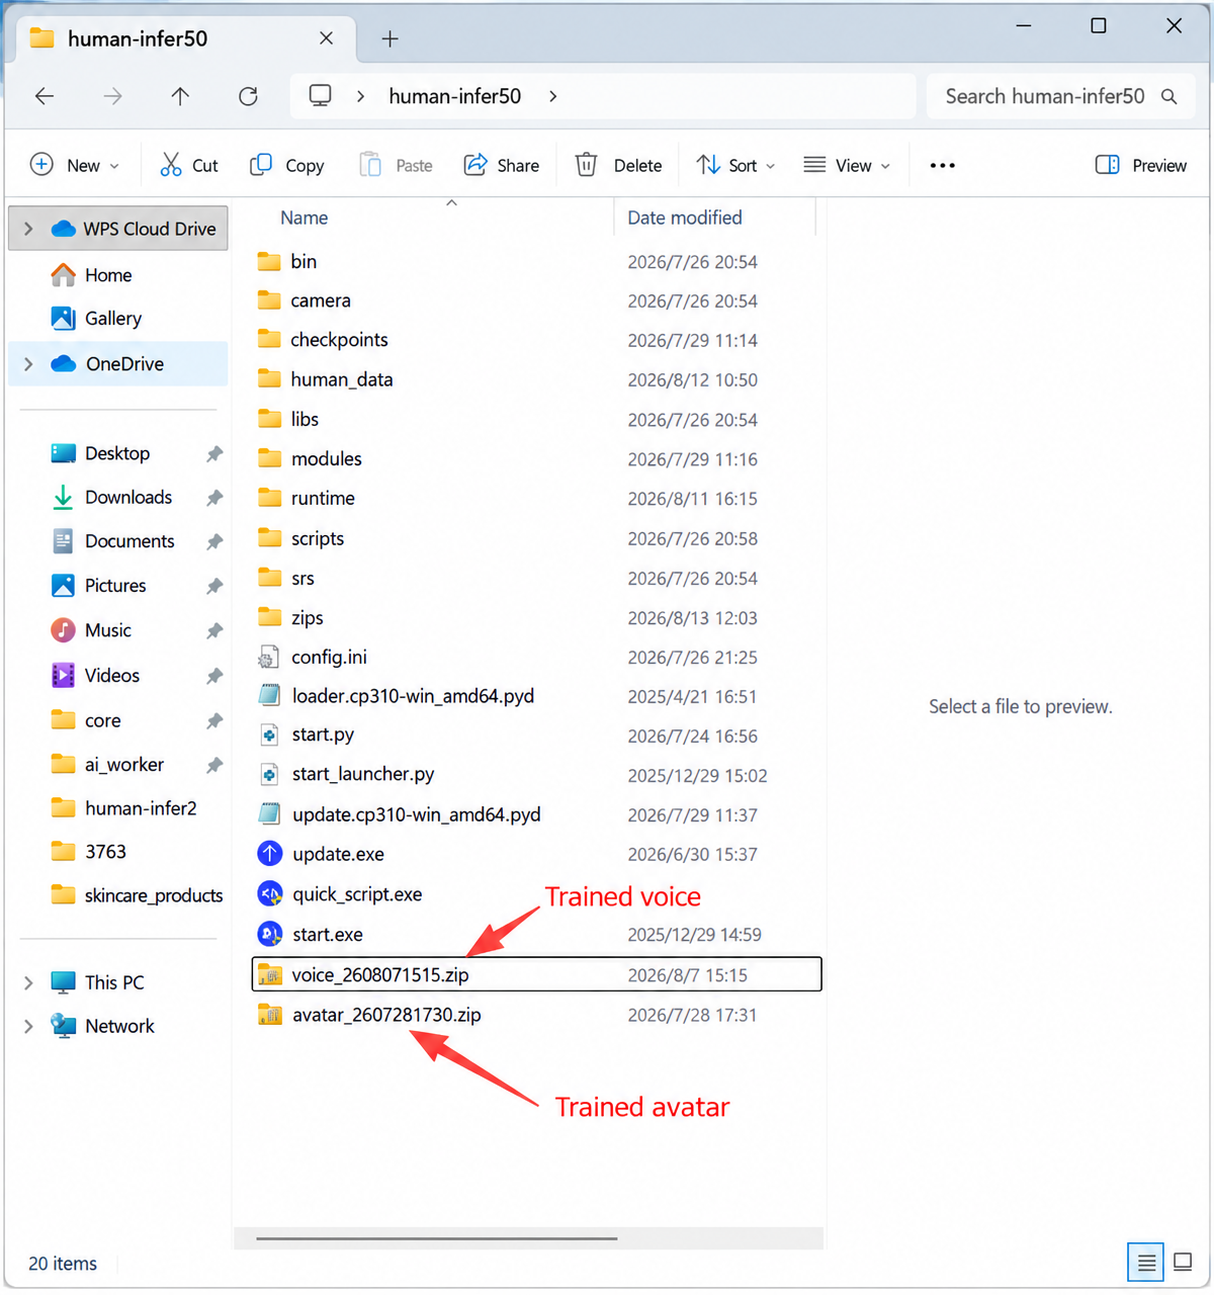
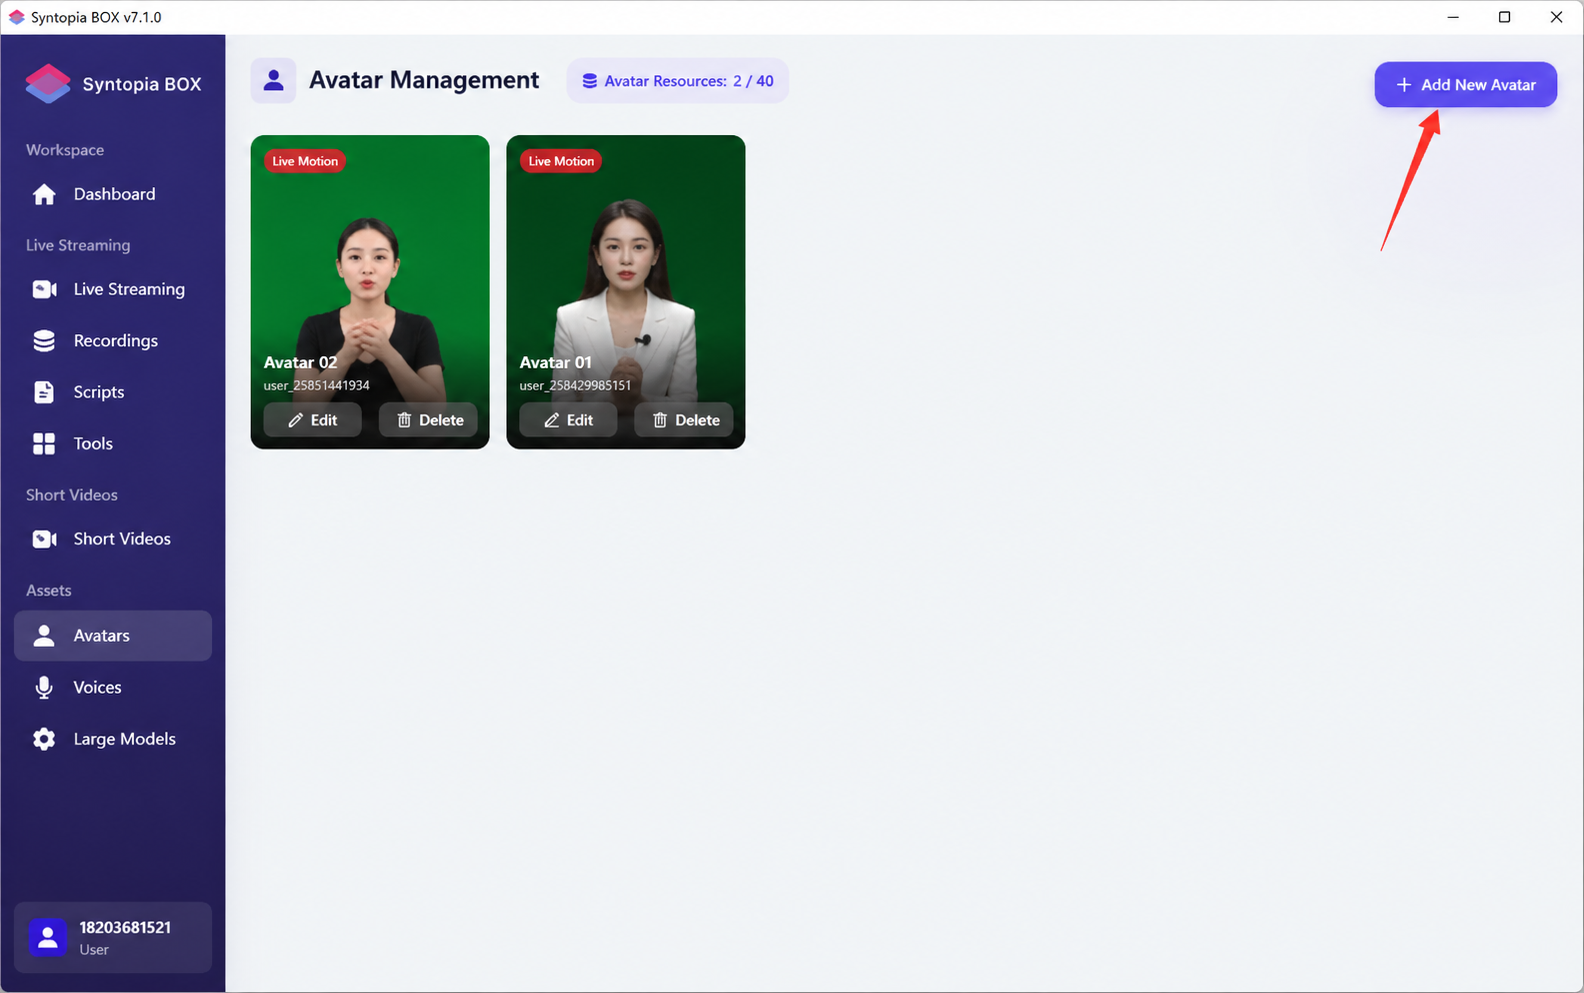
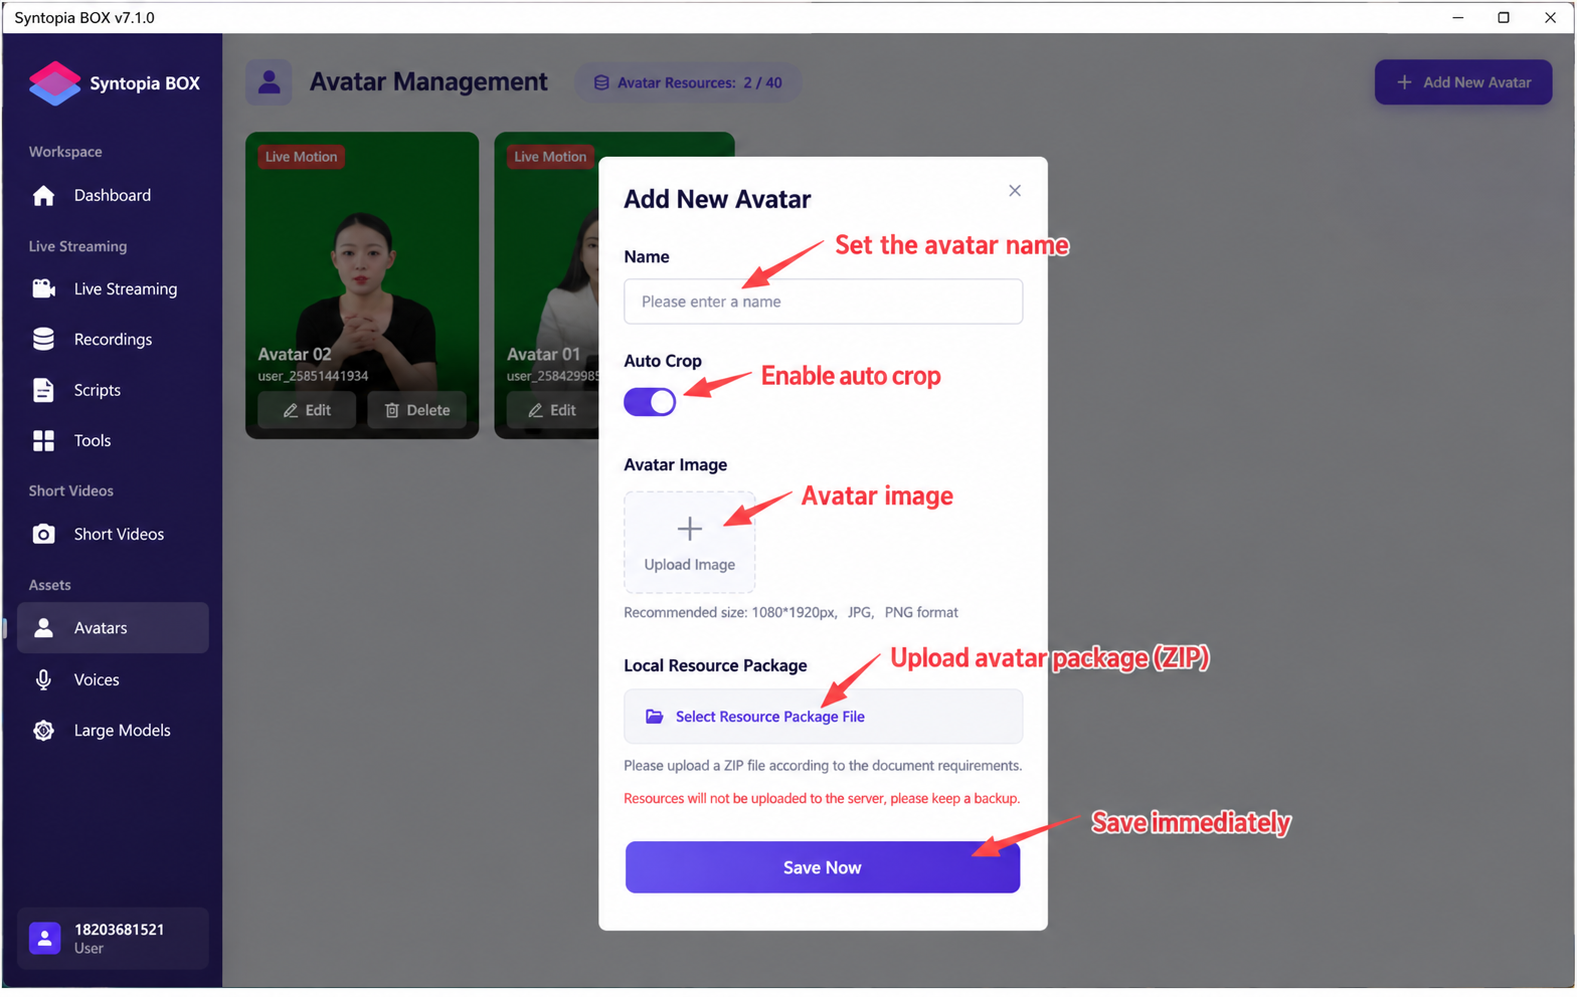
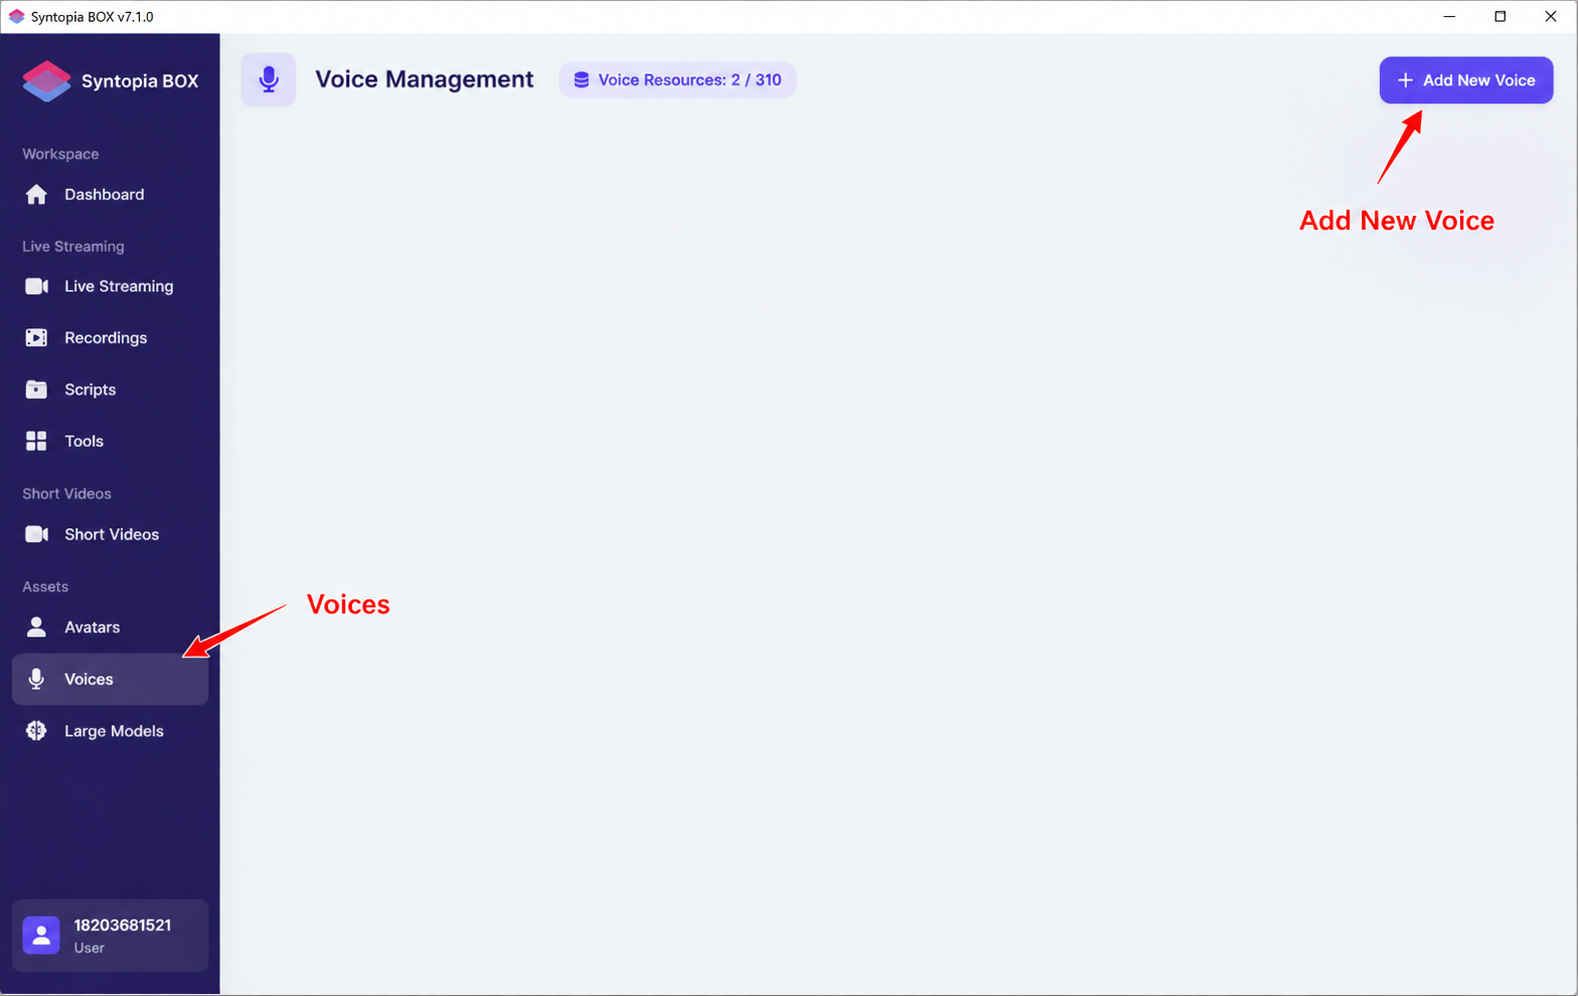
訓練形象或聲音後,安裝目錄中會產生一個形象/聲音的 zip 壓縮包。在用戶端主畫面的「Model」/「Voice」處,上傳對應已訓練好的模型或聲音 zip 壓縮包。